
Self-Healing Infrastructure dengan Live AI Agent: Deteksi, Putuskan, Pulihkan
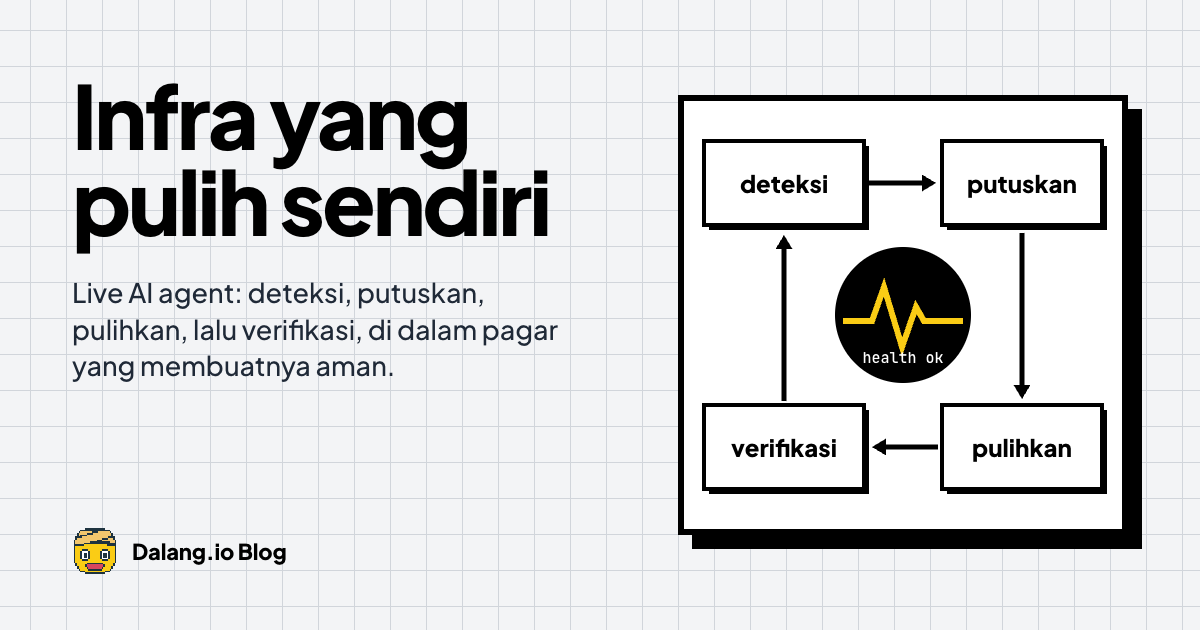
Infrastruktur yang memulihkan dirinya sendiri bukan sihir: ia loop tertutup antara health check, agent yang membaca konteks, tindakan terbatas, dan verifikasi. Ini tingkat otonomi, contoh nyata, dan pagar yang membuatnya aman.
Infrastruktur yang Pulih Sebelum Kamu Bangun
Pukul 03:12, sebuah service berhenti merespons. Pukul 03:13, health check gagal. Pukul 03:14, sebuah agent membaca log, melihat pola yang sama dengan insiden dua minggu lalu, menjalankan satu tindakan yang sudah diizinkan, dan memverifikasi bahwa service kembali sehat. Pukul 03:15, satu baris audit tercatat.
Tidak ada telepon. Tidak ada halaman dashboard yang dibuka sambil mengantuk.
Itulah janji self-healing infrastructure: bukan sistem yang tidak pernah gagal, melainkan sistem yang bisa menutup loop antara deteksi dan pemulihan tanpa menunggu manusia.
Self-Healing Bukan “Auto-Restart”
Auto-restart adalah level paling dasar. Self-healing yang berguna punya empat langkah:
- Deteksi — health check, metrik, log, atau alarm eksternal.
- Keputusan — apa penyebab yang paling mungkin, tindakan apa yang aman, apa risikonya.
- Tindakan — dijalankan lewat API atau perintah yang terbatas dan idempoten.
- Verifikasi — apakah masalahnya benar-benar hilang? Kalau tidak, eskalasi.
Tanpa langkah keempat, kamu hanya menambah tindakan otomatis ke sistem yang belum tentu pulih.
Tingkat Otonomi
Tidak semua tindakan layak diberikan ke agent. Pecah berdasarkan risiko:
| Level | Contoh | Siapa yang memutuskan |
|---|---|---|
| L1 — Reaktif | Restart service yang crash, bersihkan file sementara | Agent, otomatis |
| L2 — Korektif | Ganti instance yang tidak sehat, perbarui sertifikat, tutup koneksi bermasalah | Agent, otomatis dengan batas |
| L3 — Konfigurasi | Ubah timeout, tambah worker, alihkan trafik | Agent mengusulkan, manusia menyetujui |
| L4 — Perubahan sistem | Patch, migrasi, perubahan topologi | Manusia, dengan bantuan agent |
Semakin tinggi levelnya, semakin besar blast radius dan semakin penting audit serta rollback.
Apa Arti “Live”
Agent yang “live” bukan chatbot yang ditanya saat ada masalah. Ia berjalan terus, membaca telemetri, dan punya state:
- Health check berkala — misalnya setiap 5 detik untuk layanan kritis.
- Ambang dan anomali — bukan hanya “mati”, tapi juga “lambat”, “error rate naik”, “disk hampir penuh”.
- Memori insiden — pola yang pernah terjadi, tindakan yang dulu berhasil.
- Antrean tindakan — satu tindakan pada satu waktu per resource, supaya tidak saling bertabrakan.
Tanpa state, agent hanya mengulang reaksi yang sama setiap kali.
Contoh Loop yang Sederhana
Untuk satu service di belakang reverse proxy:
health check gagal (3x berturut-turut)
  → agent membaca log 15 menit terakhir
  → tidak ada deploy dalam 30 menit terakhir
  → pola sama dengan insiden 2026-10-09: proses kehabisan memori
  → tindakan: restart unit, lalu tunggu health check selama 60 detik
  → sehat? catat, selesai
  → tidak sehat? eskalasi ke manusia + buka tiket dengan ringkasan
Yang membuat ini aman bukan kecerdasan modelnya, melainkan batas tindakannya: restart satu unit, bukan reboot server.
Pagar yang Membuat Self-Healing Layak Dipercaya
- Allowlist tindakan. Agent tidak punya shell bebas. Setiap tindakan adalah perintah bernama dengan parameter terbatas.
- Idempotensi. Menjalankan tindakan dua kali tidak boleh memperburuk keadaan.
- Circuit breaker. Setelah beberapa kegagalan berturut-turut, berhenti dan eskalasi.
- Batas biaya dan frekuensi. Terutama untuk tindakan yang memicu resource baru atau biaya.
- Audit yang tidak bisa dihapus. Input, keputusan, tindakan, hasil, dan siapa yang mengizinkan.
- Rollback yang diuji. Kalau tindakan salah, harus ada jalan kembali yang sudah pernah dicoba.
- Pemisahan data dan instruksi. Log dan konten eksternal tidak boleh menjadi perintah bagi agent.
- Mode read-only lebih dulu. Jalankan agent sebagai pengamat selama berminggu-minggu sebelum memberinya izin menulis.
Kapan Self-Healing Tidak Cocok
- Data corruption. Tindakan otomatis bisa menyebarkan kerusakan sebelum ketahuan.
- Insiden keamanan aktif. Isolasi boleh otomatis; penghapusan bukti dan pemulihan harus hati-hati.
- Kegagalan baru yang belum pernah terlihat. Agent yang memaksa pola lama ke masalah baru bisa memperburuk.
- Perubahan yang mengubah arsitektur. Itu keputusan manusia.
Self-healing bukan pengganti observability dan backup. Ia lapisan di atas keduanya.
Mulai dari Mana
- Ukur dulu. Kalau health check dan metrik belum rapi, agent hanya akan bereaksi lebih cepat terhadap informasi yang salah.
- Tulis runbook. Setiap tindakan otomatis harus berasal dari prosedur yang sudah jelas dan pernah dijalankan manusia.
- Read-only. Biarkan agent mengamati dan mengusulkan selama beberapa minggu; bandingkan usulannya dengan tindakan manusia.
- Otomatiskan yang reversibel. Restart, bersihkan, ganti instance. Tahan yang destruktif.
- Ukur hasilnya. Berapa lama waktu pemulihan turun? Berapa kali agent salah? Berapa kali eskalasi?
Di Dalang, blok bangunannya tersedia terpisah — bukan sebagai produk self-healing siap pakai: uptime.dalang.io memeriksa layanan tiap 5 detik, Dalang CLI menyediakan perintah yang bisa dibaca mesin dengan output JSON dan mode non-interaktif untuk workflow yang disetujui, sementara VPS dan baremetal memberi tempat menjalankan agent-nya sendiri.
Yang tidak kami jual: janji bahwa agent tidak akan pernah salah. Yang bisa dibangun: loop yang aman untuk salah — dengan batas, audit, dan jalan pulang.