
Advisor dan Judge di omp: Dua Model Tambahan yang Membuat Hasil Lebih Bisa Dipercaya
Advisor mengawasi proses kerja dan menegur saat arahnya salah; judge menilai banyak hasil dengan rubrik yang sama dan memberi probabilitas. Ini bedanya, kapan dipakai, dan kenapa keduanya lebih murah daripada rework.
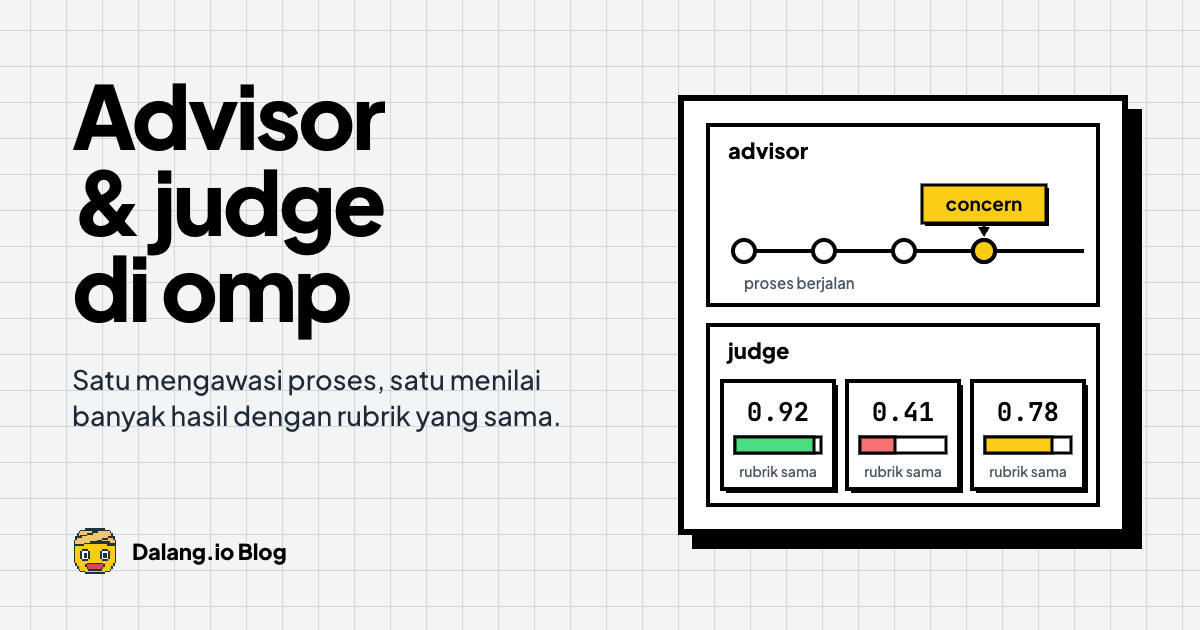
Dua Lapisan Review yang Berbeda
Satu agent yang bekerja cepat tetap bisa menghasilkan pekerjaan yang salah. Masalahnya biasanya bukan model yang kurang pintar, melainkan tidak ada yang memeriksa arah pekerjaan sebelum terlambat.
omp punya dua mekanisme yang berbeda untuk itu:
- Advisor — reviewer pasif yang mengawasi proses dan menyisipkan catatan saat pekerjaan berjalan.
- Judge — penilai terstruktur yang memberi keputusan (pilihan, ya/tidak, skor) atas satu atau banyak hasil, dengan rubrik yang sama.
Keduanya bukan pengganti test. Keduanya mengurangi jumlah kesalahan yang baru ketahuan di akhir.
Advisor: Mengawasi Proses
Advisor adalah model kedua yang menerima potongan transkrip utama dan boleh memeriksa workspace dengan alatnya sendiri (read, grep, glob). Ia tidak menyetujui tindakan dan tidak mengubah state sesi; ia hanya mengirim catatan.
Aktifkan:
# config
advisor:
  enabled: true

modelRoles:
  advisor: anthropic/claude-sonnet-4-5:medium
Atau untuk satu proses headless:
omp -p --advisor "review this refactor plan"Perintah sesi:
/advisor status
/advisor on
/advisor off
/advisor dump
Catatan advisor punya tiga tingkat:
| Tingkat | Kapan dipakai |
|---|---|
nit | Perapian, penyederhanaan, edge case kecil |
concern | Risiko material, arah yang mungkin salah, API yang tidak ada |
blocker | Melanjutkan jelas akan membuang pekerjaan atau menghasilkan output rusak |
blocker bisa menyela; concern bisa mengarahkan ulang; nit menunggu batas turn. Semuanya muncul di transkrip sebagai elemen <advisory> yang bisa kamu baca dan nilai sendiri.
Mengarahkan Advisor
Dua berkas mengatur fokusnya:
WATCHDOG.md— panduan review: jebakan proyek, API berbahaya, batas arsitektur.WATCHDOG.yml— daftar advisor: nama, model, alat, dan instruksi khusus.
Contoh:
advisors:
  - name: Architecture
    model: anthropic/claude-sonnet-4-5:medium
    tools: [read, grep, glob]
    instructions: |
      Awasi coupling antar-modul dan pertumbuhan public API.

  - name: Final reviewer
    reviewMode: agent-end
    reviewInterval: 3
    instructions: |
      Review seluruh turn. Diam kecuali ada bukti masalah material.
Dengan roster, kamu bisa punya beberapa reviewer dengan spesialisasi berbeda — dan masing-masing punya biaya serta konteks sendiri.
Kenapa Advisor Berguna
- Menangkap arah yang salah lebih awal. Menghentikan refactor yang salah di menit kelima jauh lebih murah daripada setelah 40 berkas berubah.
- Menemukan API yang tidak ada. Model utama bisa percaya diri memanggil fungsi yang tidak pernah ada; reviewer yang membaca kode bisa menangkapnya.
- Menjaga batas arsitektur. Aturan yang terlalu berisik untuk prompt utama bisa ditaruh di
WATCHDOG.md.
Yang tidak dilakukan advisor: menjalankan test untukmu, menyetujui tindakan, atau menjamin kebenaran. Ia reviewer, bukan gate.
Judge: Menilai Banyak Hasil dengan Rubrik yang Sama
Kalau advisor mengawasi proses, judge menilai hasil — dan bisa melakukannya dalam jumlah besar.
Judge menerima satu state (teks, objek JSON, atau array) dan beberapa pertanyaan. Setiap pertanyaan dijawab independen:
await judge(
  state,
  {
    "risk": {
      "type": "choice",
      "instructions": "Seberapa berisiko perubahan ini?",
      "criteria": {
        "low": "hanya dokumentasi atau test",
        "medium": "perubahan perilaku dengan test",
        "high": "mengubah kontrak data atau jalur uang"
      }
    },
    "needs_human": {
      "type": "bool",
      "instructions": "Apakah ini butuh keputusan manusia sebelum merge?"
    }
  }
)
Tipe jawaban:
choice— pilih satu label dari rubrik, dengan probabilitas per label dan confidence.bool— probabilitas ya.score— skor pada skala ordinal (mis. 1–5), dengan distribusi probabilitas.
Untuk banyak state sekaligus, gunakan judge_batch, bukan loop:
b = judge_batch(
  {f"pr-{i}": diff for i, diff in enumerate(diffs)},
  questions,
  concurrency=32,
)
async for key, item in b.drain_iter(timeout=60):
    print(key, item.answers)
judge_batch berjalan di host, punya batas konkurensi, dan hasilnya bisa di-drain bertahap.
Kenapa Judge Berguna
- Konsisten. Semua item dinilai dengan rubrik yang sama, bukan prompt yang sedikit berbeda tiap kali.
- Terukur. Kamu mendapat probabilitas dan confidence, bukan hanya label.
- Murah dan cepat. Judge memakai model kecil/cepat; ia tidak butuh tools atau riwayat percakapan.
- Cocok untuk pipeline. Klasifikasi tiket, triase alert, ranking kandidat, skor kualitas konten, deteksi output yang perlu review manusia.
Yang tidak dilakukan judge: menggantikan keputusan berisiko tinggi. Ia memberi sinyal; ambang dan konsekuensinya tetap milikmu.
Kapan Memakai yang Mana
| Kebutuhan | Advisor | Judge |
|---|---|---|
| Mengawasi pekerjaan yang sedang berjalan | ✅ | — |
| Menegur arah yang salah sebelum selesai | ✅ | — |
| Menilai 50–5.000 hasil dengan rubrik sama | — | ✅ |
| Klasifikasi/ranking dengan confidence | — | ✅ |
| Keputusan akhir merge/deploy | — | — (manusia) |
Pola yang sering bekerja: advisor selama kerja, judge setelah hasilnya banyak. Advisor menjaga proses tetap di jalur; judge memilah hasil mana yang layak dilihat manusia lebih dulu.
Pagar yang Tetap Berlaku
- Rubrik yang buruk menghasilkan penilaian yang buruk. Tulis kriteria yang bisa dibedakan, bukan “kualitas bagus”.
- Kalibrasi. Uji judge pada sampel berlabel sebelum memakainya untuk keputusan.
- Jangan jadikan judge satu-satunya gate. Ia probabilitas, bukan bukti.
- Catat hasilnya. Simpan skor, confidence, dan versi rubrik supaya bisa dibandingkan.
- Perhatikan biaya. Advisor punya usage terpisah; judge batch punya biaya per item. Keduanya murah, bukan gratis.
Kesimpulan
Advisor dan judge bukan fitur yang membuat agent “lebih pintar”. Keduanya membuat kesalahan lebih cepat terlihat — satu selama proses, satu setelah hasilnya terkumpul.
Kalau kamu sudah memakai omp untuk pekerjaan yang menyentuh produksi, keduanya adalah lapisan murah yang mengurangi rework. Mulai dari satu advisor dengan WATCHDOG.md yang berisi tiga jebakan proyek, lalu tambahkan judge untuk satu keputusan yang sekarang masih kamu nilai manual.
Informasi dan pemasangan: omp.sh.